有道翻译能翻译扫描版PDF吗?
发布时间:2026-10-09
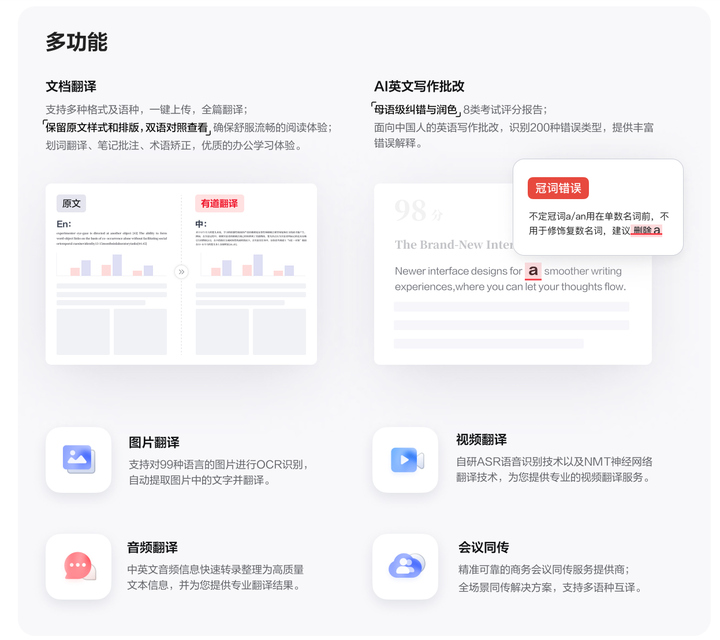
有道翻译可以尝试处理扫描版PDF,操作时先确认文件能够正常打开,再进入文档翻译功能上传PDF并设置源语言和目标语言。扫描版PDF需要先识别图片中的文字,再进行翻译,因此清晰度会影响结果。完成后重点检查数字、表格、专有名词和模糊页面,若有漏译,可单独截图重新识别翻译。
有道翻译扫描版PDF翻译功能介绍
扫描版PDF需要先完成文字识别
- 扫描文件和普通PDF存在区别:普通PDF通常带有可以直接选择、复制的文字层,而扫描版PDF本质上更接近一张张页面图片,因此在真正翻译之前,需要先把图片中的文字识别出来。有道相关OCR能力明确支持识别图片、PDF等扫描文档中的文字,因此扫描资料可以采用“文字识别+翻译”的方式处理。(有道智云)
- PDF可以作为文档翻译对象处理:有道文档翻译相关服务支持PDF等文件格式,桌面端也提供文档翻译能力,因此遇到扫描PDF时,可以先尝试通过当前版本的文档翻译功能上传。如果文件能够正常解析,就继续查看译文;如果扫描内容没有被完整识别,则需要结合OCR、图片翻译或截图翻译补充。(有道智云)
- 识别效果会影响最终翻译质量:扫描版PDF与普通文本PDF相比,多了一层文字识别过程。如果原页面清晰、文字排列规则,后续翻译通常更容易校对;如果图片模糊、倾斜或文字过小,识别阶段就可能产生错字,之后即使翻译语言本身没有问题,译文也可能因为原文字识别错误而出现偏差。
扫描PDF适合按照页面质量选择处理方式
- 清晰扫描件可以先整份尝试:如果PDF由高清扫描页面组成,字体大小正常、背景干净,可以先直接通过文档翻译功能测试。处理完成后重点抽查首页、中间页和最后一页,确认文字识别和翻译是否完整。如果结果基本正常,再继续进行全文校对,可以减少逐页截图的操作。
- 模糊页面可以单独截取处理:整份PDF中可能只有少数页面拍摄模糊、存在阴影或字体很小,没有必要因为几页异常就重新处理全部文件。可以把问题页面单独截取,再通过图片或截图识别方式处理,然后把补充译文整理回原来的章节位置。
- 重要资料建议保留原文件对照:论文、合同、说明书和历史扫描资料在翻译后最好保留原始PDF。校对过程中遇到数字、人名、专业术语或识别不确定的文字,可以随时返回扫描原图确认,避免仅根据已经识别出来的文本判断原意。
有道翻译扫描版PDF怎么上传翻译
上传前先检查扫描文件状态
- 确认PDF能够正常打开浏览:开始翻译以前,可以先用PDF阅读工具打开文件,从第一页浏览到最后一页,确认没有空白页、缺页、文件损坏或无法显示的问题。如果原文件自身就存在读取异常,应先重新保存或重新生成PDF,再进入有道翻译处理。
- 判断页面是否属于扫描图片:可以尝试在PDF中选中一段文字。如果完全无法选择,而页面看起来像照片或扫描图,通常说明主要内容是图片形式。这样的文件后续处理重点就不仅是语言翻译,还包括文字识别准确性,因此校对时需要比普通PDF更加仔细。
- 文件较大时提前考虑拆分:几十页高清扫描图片可能让PDF体积明显增加。有道文档翻译服务对文件大小和复杂页面存在处理限制,页面较多或结构复杂时也可能出现转换失败,因此大文件更适合根据章节或固定页面范围进行拆分。
进入文档翻译后设置语言方向
- 选择PDF文件并开始上传:打开有道翻译后,可以进入文档翻译相关功能,选择需要处理的扫描PDF。桌面端目前提供文档翻译等能力,而具体按钮名称和页面位置可能随着版本调整,因此操作时应以当前客户端实际显示为准。
- 设置正确的源语言和目标语言:上传以前或任务开始前,应确认扫描内容主要使用什么语言,并设置对应目标语言。如果整份资料主要是英文,就选择与英译中相符的方向;如果夹杂少量其他语言,则可以先处理主要语言,再单独检查混合语种页面。
- 上传完成后先进行局部抽查:不要等全部后期整理完成后才检查识别效果。翻译结果生成以后,可以先查看字体较清晰的一页、表格较多的一页以及扫描质量较差的一页,判断系统能否正确识别不同类型内容,再决定是否需要采取分页面处理方式。
有道翻译扫描PDF文字怎么识别
OCR识别是扫描PDF处理的重要环节
- 先把图片文字转换成可识别内容:扫描PDF中的文字如果没有文本层,就需要通过OCR把页面图像中的字符转换成文本。有道智云提供文字识别OCR能力,并明确用于图片和PDF等扫描文档中的文字提取,因此扫描资料的处理逻辑通常是先识别内容,再进一步进行翻译。
- 印刷体通常比特殊字体更容易处理:普通书籍、报告和打印文件中的标准印刷字体通常比较规则,而艺术字、手写批注、印章覆盖文字或极细字体会增加识别难度。有道OCR提供印刷体文字识别能力,但实际扫描质量依然会直接影响最终文本是否完整。
- 识别结束后不能直接忽略原图:即使页面成功生成译文,也建议保留扫描原图进行对照,因为OCR可能把形近字符、数字或符号识别错误。例如“0”和“O”、“1”和“I”在某些字体中非常接近,正式资料中的型号、金额和日期尤其需要人工确认。
提高页面清晰度有利于后续识别
- 尽量使用分辨率较高的扫描件:原始文件越清晰,字符边缘越完整,后续文字识别越容易判断。遇到来源于手机拍照的PDF时,应注意页面是否虚焦、文字是否过小以及边缘是否被裁掉。如果有更高清的原始扫描件,优先使用清晰版本通常更合适。
- 页面倾斜可以先进行校正:如果纸张扫描时明显歪斜,文字行不再保持水平,可能增加段落识别和阅读顺序判断难度。可以先使用PDF或扫描工具进行旋转、裁切和方向校正,再重新处理,尤其是多栏文章和表格页面更需要保证页面方向正确。
- 复杂背景需要单独重点检查:有些扫描资料使用彩色纸张、带水印背景或存在阴影,这些视觉元素可能干扰文字区域判断。对于识别不理想的页面,可以单独截取正文区域,把不需要的背景和边缘去掉,再进行图片文字识别和翻译。
有道翻译扫描版PDF翻译不完整怎么办
先确定具体缺失的是哪一部分
- 检查是否只有个别页面漏译:发现译文不完整时,可以先对照PDF页码和章节标题,确认缺失的是一两页,还是从某一页以后全部没有内容。如果只是局部页面异常,就把这些页面单独处理,不需要为了几个漏译区域重新提交整份几十页文件。
- 重点检查扫描质量较差的页面:漏译位置往往可能与原图质量有关,例如页面模糊、过暗、过亮或文字被折痕遮挡。可以放大原页面观察,如果人眼都很难辨认具体字符,就需要先获得更清晰扫描件,或者对图像进行裁切和校正后再尝试识别。
- 确认文件是否因为过大被截断:如果译文前半部分正常,而后半部分大量缺失,就需要考虑文件页数、体积或处理复杂度。有道文档翻译官方说明提到,页数较多或页面结构复杂时可能出现文档转换失败,因此长扫描PDF可以拆分成多个文件分别处理。
缺失内容可以采用分段方式补充
- 按章节重新拆成较小PDF:几十页甚至上百页扫描文件可以按照目录和章节进行拆分,例如每个章节保存成一个PDF。这样既能够减少单次任务复杂度,也方便判断具体哪一部分识别存在问题,后续合并译文时还能按照章节编号快速恢复原顺序。
- 单页异常可以使用截图翻译:如果只有某张扫描页面识别失败,可以截取页面上的标题、正文或表格区域,再使用截图或图片翻译单独处理。有道桌面端提供截屏翻译和图片翻译能力,可以作为文档处理不完整时的补充方式。
- 补译以后按照原页码整理:分开处理出来的译文不要随意放在文档末尾,可以根据原PDF页码或章节编号重新插入对应位置。对于多次补译的长文件,可以在文件名或笔记中标记页面范围,避免最后出现重复内容或漏掉某一页。
有道翻译扫描PDF识别失败的常见原因
页面清晰度不足是常见影响因素
- 扫描分辨率过低可能导致错字:如果PDF来自很久以前的低清扫描,文字笔画可能已经粘连或缺失,识别时容易把相似字符判断错误。遇到大量乱码时,可以先确认是否存在更清晰的源文件,而不是连续重复使用同一份低质量扫描件进行翻译。
- 图片倾斜和透视会增加识别难度:手机拍摄纸质资料生成的PDF,如果不是正面拍摄,页面可能出现梯形透视、边缘弯曲或文字行倾斜。这样的页面最好先进行透视校正和旋转,使文字尽量恢复水平排列,再重新识别,通常更方便后续校对。
- 阴影和水印可能遮挡正文:书脊阴影、印章、水印或彩色背景覆盖文字时,部分字符可能无法完整辨认。可以尝试裁切到正文区域,或者适当提高页面对比度后重新处理。对于被完全遮挡的文字,仍然需要根据原始资料人工确认。
文档结构过于复杂也可能影响结果
- 多栏排版可能出现阅读顺序异常:论文、报纸和杂志扫描件经常采用左右双栏或多栏结构。如果页面文字区域判断不准确,识别结果可能把右栏内容接到左栏中间。遇到这种情况,可以分别截取每一栏进行识别,再按照正常阅读顺序重新整理译文。
- 表格内容可能发生行列错位:扫描表格不仅要识别文字,还要判断单元格之间的空间关系,因此比普通段落更加复杂。翻译完成后应重点对照表头、数字和备注,确认每一项仍然属于正确的行和列,避免因为位置变化产生数据含义错误。
- 手写内容需要额外人工检查:扫描PDF中如果夹杂手写批注、签名或修改痕迹,其识别难度通常高于标准印刷体。即使系统能够识别部分内容,也不能默认全部准确。涉及日期、姓名、金额或审批意见时,最好直接结合原始扫描图片人工判断。
有道翻译扫描版PDF译文怎么校对和保存
校对时先确认OCR内容是否正确
- 先检查原文字识别再看译文:扫描PDF出现翻译错误时,不一定是翻译环节本身的问题,也可能是OCR已经把原文字识别错了。因此校对时可以同时查看扫描图片、识别后的文字和最终译文,先判断原文字符是否正确,再决定是否需要修改翻译表达。
- 数字和专有名词需要重点核对:扫描文件中的日期、金额、编号、型号、人名、机构名称和专业缩写应该优先检查。这类内容一旦OCR识别错误,译文可能继续沿用错误信息,而且从语法上未必容易发现,因此不能只依赖通读译文来判断准确性。
- 表格和图片说明要逐项对照:扫描PDF中的表格、图注和页面边缘小字容易在自动处理中被遗漏。校对时可以按照原页顺序逐页查看,重点确认图1、图2等编号、表头和说明文字是否存在,并检查译文是否放在正确内容附近。
保存译文时保留完整对照资料
- 有导出功能可以按当前页面保存:有道桌面端文档翻译提供译后编辑、双语对照和导出等相关能力,但具体支持的文件格式和操作方式会随当前版本而不同,因此完成扫描PDF处理后,可以查看结果页面提供的保存或导出选项再进行操作。
- 没有合适格式可以手动整理译文:如果扫描PDF翻译后只能查看部分结果,或者导出文件的排版无法直接使用,可以把译文整理到Word等可编辑文档中,再按照原PDF章节和页码进行排列。这样更加方便修正OCR错误、统一字体和重新整理表格。
- 原PDF和最终译文分别保存:完成全部校对以后,建议保留原始扫描PDF、识别或初始翻译结果以及最终校对版。文件名称中可以增加“原文”“初译”“校对版”等标记,以后发现某个数字或专业术语需要重新确认时,就能快速返回原始扫描页面进行核对。
常见问题FAQ
有道翻译扫描版PDF识别不出文字怎么办?
可以先检查PDF页面是否清晰,确认有没有模糊、倾斜、阴影过重或文字过小的问题。如果只有少数页面识别失败,可以把对应页面单独截图,再进行图片或截图翻译。整份文件质量较差时,建议先重新扫描或提高页面清晰度后再处理。
有道翻译扫描版PDF翻译不完整怎么办?
如果译文缺少部分页面,可以先对照原PDF页码和章节标题,确认具体漏掉哪些内容。只有个别页面缺失时,可以单独处理,不必重新翻译整份文件。如果后半部分大面积缺失,可以把PDF按章节或页数拆分成多个较小文件,再分别翻译并按顺序整理。
有道翻译扫描PDF中的表格能识别吗?
扫描PDF中的表格可以尝试识别和翻译,但复杂表格比普通正文更容易出现行列错位、数字对应错误或部分文字遗漏。完成翻译后应重点检查表头、数据、单位和备注是否仍在正确位置。重要财务、统计或技术表格最好结合原始页面逐项人工核对。
有道翻译扫描版PDF翻译后排版会变化吗?
扫描版PDF本身属于图片式页面,经过文字识别和翻译后,译文长度、字体和换行方式都可能与原文不同,因此排版不一定完全保持原样。双栏页面、图片较多或复杂表格尤其容易发生变化。正式使用前建议逐页检查,并根据需要重新调整文字和页面布局。